我拿 292 张自己的截图,考了六个 AII quizzed six AI models on 292 of my own screenshots
This post is in Chinese.
DanOS 里的 DanShots 做一件事:把你每天截的图,按「你为什么截它」分进几个文件夹。想试的工具、想看的剧、要盯的股、留着查的资料、纯好看的。分类这一步靠视觉模型,默认是 Claude Haiku。
国内用户开不了 Anthropic 的户。所以今年 8 月我做了一轮评测,想知道国产模型能不能顶上。10 月 DeepSeek 学会看图了,又补测了一轮。这篇把两轮合在一起写。
评测怎么做
评测集是我自己的 292 张截图,每张都有 Haiku 当时给的分类,而且经过几个月日常使用的检验。排除了含敏感信息的。
指标只有一个:候选模型的分类和 Haiku 的分类一致的比例。prompt 一字不改,就是产品里那份。
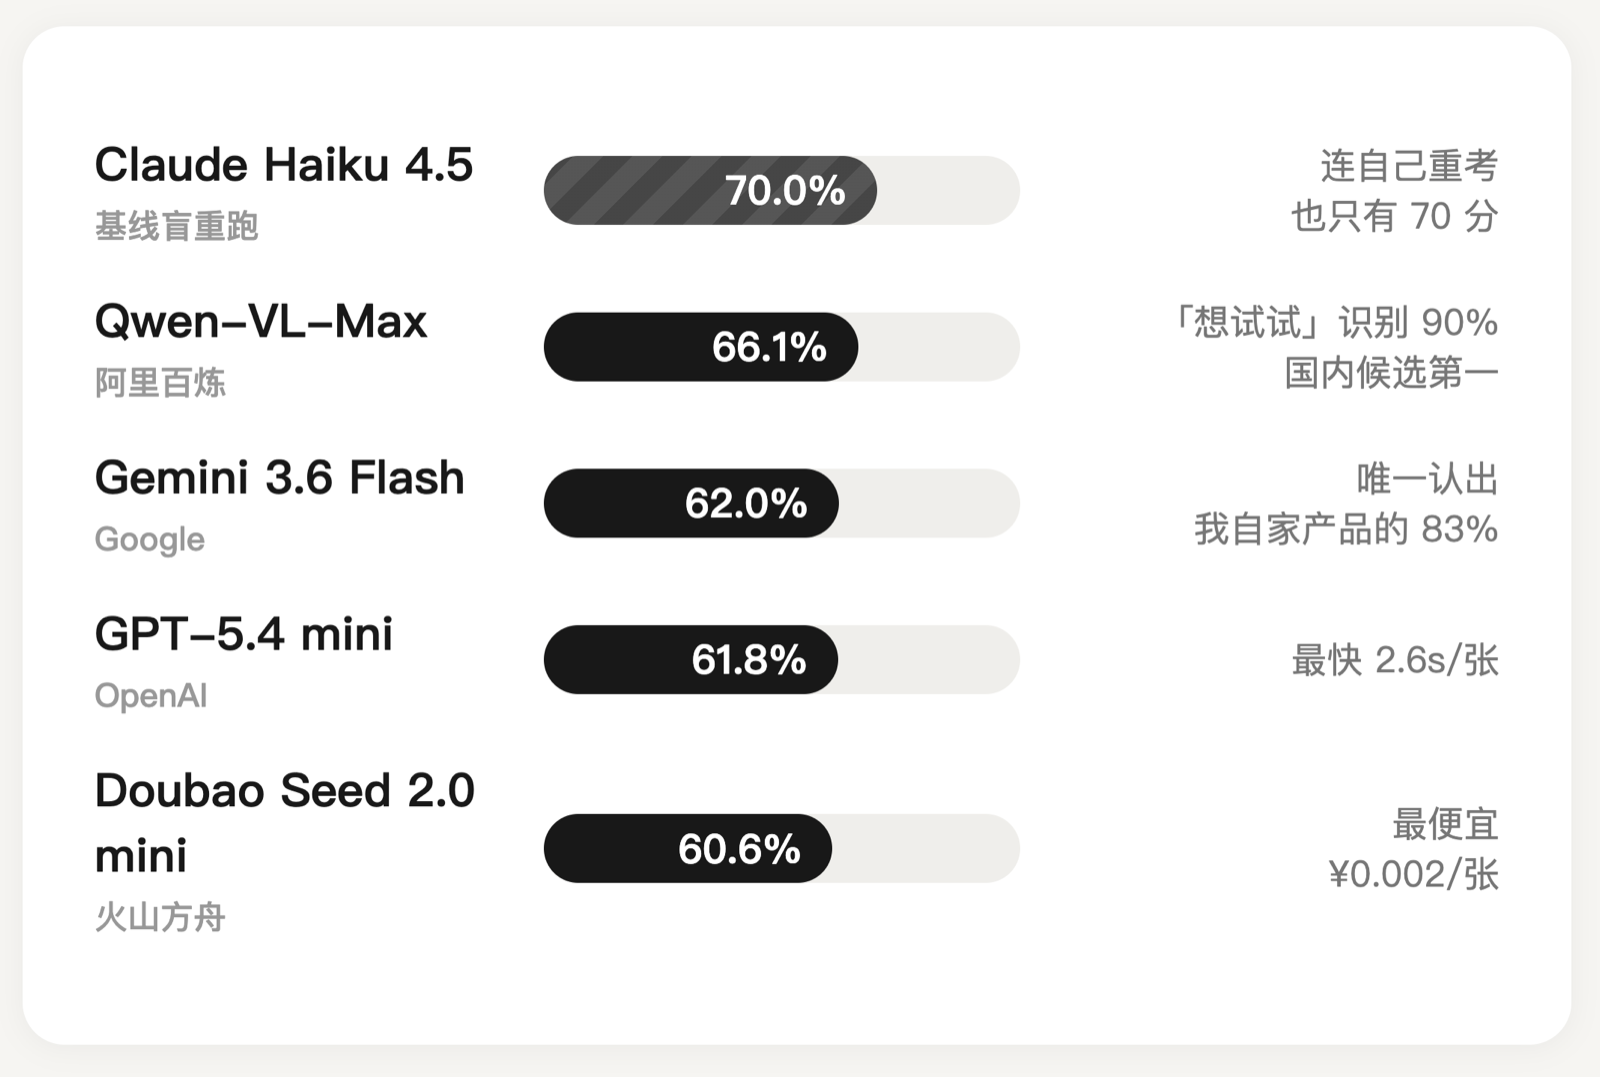
有一个数字先要说清楚:让 Haiku 自己盲重跑一遍,和它自己三个月前的标注一致率只有 70%。 一张「漂亮的陶罐」,是想买(工具)还是留着看(灵感),动机本来就有三成的摇摆。所以 66% 不是「比 Haiku 差一截」,是追平了基线模型自己的复现水平。这个任务的天花板在基线,不在候选。
8 月:五家对拍
| 模型 | 一致率 | 延迟 | 单张成本 |
|---|---|---|---|
| Claude Haiku 4.5(自我复现) | 70.0% | 3.1s | ¥0.032 |
| 千问 VL-Max | 66.1% | 2.9s | ¥0.013 |
| GPT-5.6 Luna | 62.2% | 2.8s | 约 ¥0.01 |
| Gemini 3.6 Flash | 62.0% | 3.4s | 低 |
| 豆包 Seed 2.0 mini | 60.6% | 9.4s | ¥0.002 |
分到簇上看,差距不在「看不看得清」。五家对截图里的文字和内容描述全都准确。差距在动机推断,和对这套 prompt 的遵循深度。两个典型:
- 我自己的产品(portfolio 簇):prompt 里明写了产品名,千问仍然只认出 12%,Gemini 认出 83%。
- 垃圾图(noise 簇):千问和豆包一张都不判。prompt 说得再清楚,它们也不愿意说「这张没用」。
针对第一条,我给千问加了一段「先查自家产品指纹」的补充规则,portfolio 从 12% 提到 75%,总分 68.2%。第二条放弃了:Haiku 自己复现 noise 也只有 7%,这不是候选的问题。
10 月:DeepSeek 看图
8 月评测时 DeepSeek 的 API 是纯文本,不在候选里。8 月 21 日它上了视觉模型,而且 Anthropic 兼容接口自带联网搜索。补测,同一套 292 张,同一份 prompt。
| 配置 | 一致率 | 工具 | 资料 | 我的产品 | 垃圾图 |
|---|---|---|---|---|---|
| DeepSeek flash,不加任何调优 | 66.8% | 79% | 61% | 71% | 20% |
| DeepSeek flash,加千问那段指纹规则 | 65.8% | 69% | 55% | 83% | 33% |
| 千问 VL-Max,不加调优 | 66.1% | 90% | 72% | 12% | 0% |
| 千问 VL-Max,加指纹规则 | 68.2% | 86% | 59% | 75% | — |
三个观察:
- 总分和千问打平。两边都在那 30% 的摇摆带里,分不出高下。
- 不用任何补充规则,DeepSeek 就认得我自己的产品。它对 prompt 里已有的描述遵循得更好。反过来,给它加千问那段指纹规则,工具簇从 79% 掉到 69%,规则太强势,把别人的工具也往「我的产品」里拉。所以这段规则是千问专用的。
- 工具簇它比千问低。29 张里差 3 张,样本小,但方向一致。这是 DanShots 最核心的一个簇。
成本按 DeepSeek 官方人民币价目,空闲时段(工作日 9 到 12 点、14 到 18 点之外)一张约 ¥0.0035,千问 ¥0.013。292 张零调用失败,平均 3.6 秒。
两个接入的坑,记下来省别人的时间:DeepSeek 看图只在 Anthropic 兼容接口上有,OpenAI 兼容那条看不了;它是思考模型,分类这种只要一行 JSON 的任务必须把思考关掉,不关的话 200 个 token 的额度全被思考吃光,正文是空的。
研究那条线
分完类之后还有一步:对想试的工具做一次联网研究。这条线 8 月也评过,方法是让两个不同家的模型做裁判盲评。当时国产候选里没有满意的,DeepSeek 要靠外挂的搜索引擎才能给出真实链接,好处是链接可达率全场最高(78%),代价是用户要多申请一把搜索 key。
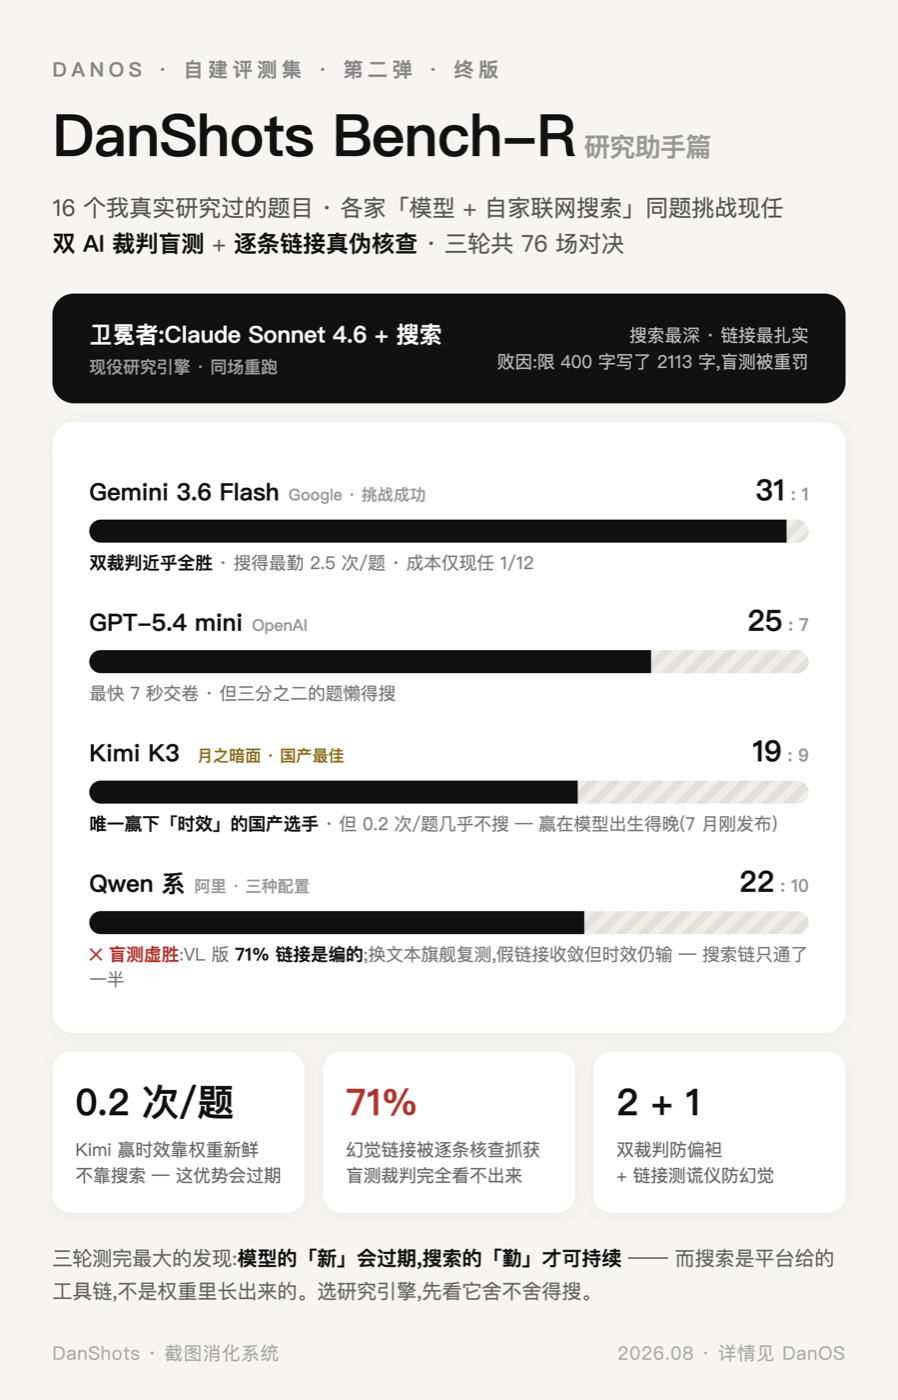
现在 DeepSeek 自带联网了。实测一次请求,它看着截图搜了两次,给出的网址都是真的。对用户的意义是国内版从三把 key 变成一把。
成本怎么算
分类一张图的成本,按各家官方价目,假设固定:prompt 约 2500 个 token,一张截图按各家的计法折成 token,输出 150 个 token。DeepSeek 一张截图最多算 384 个 token,实测 247;千问按像素折算,一张约 1250 个。
| 模型 | 每张 | 每天 50 张,一个月 |
|---|---|---|
| Claude Haiku 4.5 | ¥0.032 | ¥48 |
| 千问 VL-Max | ¥0.013 | ¥19.5 |
| GPT-5.6 Luna | 约 ¥0.015 | 约 ¥22 |
| Gemini 3.6 Flash | 约 ¥0.010 | 约 ¥15 |
| DeepSeek flash | ¥0.0035 | ¥5.3 |
| 豆包 Seed 2.0 mini | ¥0.002 | ¥3 |
DeepSeek 的价格分时段:北京时间工作日 9 到 12 点、14 到 18 点是高峰,价格翻倍,一张 ¥0.007;其余时间和周末全是空闲价。DanShots 的整理在晚上,永远是空闲价。如果 prompt 走缓存,那 2500 个 token 几乎不要钱,一张可以压到 ¥0.001。
研究一次的成本差距更大,因为要联网搜索、要读搜索结果:
| 引擎 | 每次 | 每天 10 次,一个月 |
|---|---|---|
| Claude Sonnet + 自带搜索 | 约 ¥0.8 | 约 ¥240 |
| DeepSeek v4-pro + 外挂博查 | 约 ¥0.04,博查另计 | 约 ¥12 加博查 |
| DeepSeek flash + 自带搜索 | 约 ¥0.017 | 约 ¥5 |
DeepSeek flash 这一行是实测:一次研究读进 13.9k 个 token,写出 0.7k,搜索结果算在输入里,没有单独的搜索费。
所以国内版一个重度用户一个月的开销,分类加研究,大约 10 块钱。
结论
国产模型给截图分类,够用。千问和 DeepSeek 都追平了基线模型自己的复现水平,差的那几个点在任务本身的摇摆里。接下来想提分,不是换模型,是换基线:要么人工精标,要么多个模型投票。
DanOS 目前的选择:国内版默认 DeepSeek,分类和研究一把 key,千问留作可选。工具簇那 3 张图的差距,我决定用一把 key 的省事换。评测脚本和逐张结果我都留着,方法不复杂。数据是我自己的截图,换一个人的截图,评出来的数会不一样。